Was genau ist „Künstliche Intelligenz“?
Eine Zäsur in der Geschichte der Technologie
22.04.2025 • Michael Blömeke • Künstliche Intelligenz
1. Einleitung: Warum jetzt?
Kaum ein Begriff hat in den letzten Jahren für so viel Aufsehen gesorgt wie „Künstliche Intelligenz“. Doch was bedeutet KI heute eigentlich – jenseits von Buzzwords, Mythen und Ängsten? Und was genau hat sich technisch verändert, dass wir plötzlich über den „Durchbruch“ sprechen?
Die gegenwärtige Entwicklung markiert keine schrittweise Verbesserung – sondern eine Zäsur. Eine neue Art, wie Computer Informationen verarbeiten, verstehen und mit der Welt interagieren.
Wer die erste Mondlandung 1969 bewusst miterlebt hat – am Schwarzweiß-Röhrenfernseher mit Life-Aufnahmen aus amerikanischen Fernsehanstalten auf denen nach heutigen Maßstäben fast nichts zu sehen war, oder wer sich bewusst an den Moment – irgendwann in den 80ern – erinnern kann, als endlich das Modem-Gequietsche beendet war und man mit seinem Rechner zum erstenmal eine Verbindung zum Internet hatte, oder wer sich bewusst an die Situation – irgendwann in den 90ern – erinnern kann, als man sein erstes Handy zum erstenmal aufgeklappt, die Antenne herausgezogen und einfach gewählt und telefoniert hat – draußen, ohne Kabel, frei… – Jede und Jeder, der sich an eine solche Begebenheit erinnert, kann vielleicht besser nachvollziehen, was mit Zäsur gemeint ist. Nichts mehr nach einem solchen Moment ist mehr wie vorher.
Die Welt verändert sich in relativ kurzer Zeit grundlegend. Wie und wann genau und in welchem Umfang – das kann niemand vorhersagen. Denn anders, als bei der Mondlandung, ist der Beginn des KI-Zeitalters nicht genau zu benennen, denn es ist ein fließender Prozess, den wir alle gerade miterleben. Wir stecken quasi mittendrin in einer rasanten Entwicklung, deren vorläufiges Ende nicht absehbar ist.
2. Vom Algorithmus zur „Intelligenz“: Der technologische Umbruch
Klassische Informatik vs. Moderne KI
In der klassischen Informatik beruhte das meiste auf deterministischen Regeln: Ein Programm folgte einer exakten Abfolge von Anweisungen, geschrieben von Menschen, kontrollierbar, logisch, reproduzierbar. Ob Textverarbeitung oder Finanzberechnungen – alles basierte auf expliziten „Wenn-Dann“-Logiken.
Die moderne KI – insbesondere das maschinelle Lernen – kehrt dieses Prinzip um: Computerprogramme lernen Muster aus Daten, oft ohne dass der Mensch jeden Schritt exakt vorgibt. Das Verhalten wird aus Erfahrung abgeleitet, nicht aus Programmcode im klassischen Sinne.
Das Thema „Vom Algorithmus zur „Intelligenz“ genauer betrachtet
Die gegenwärtige Entwicklung im Bereich der künstlichen Intelligenz (KI) markiert einen fundamentalen Paradigmenwechsel in der Geschichte der Computertechnik. Während frühere Generationen von Programmen auf expliziten, deterministisch formulierten Anweisungen beruhten, erleben wir heute einen Übergang hin zu datengetriebenen, selbstlernenden Systemen. Diese Systeme verhalten sich nicht mehr wie klassische Maschinen, sondern zeigen Merkmale, die im weiteren Sinne als „intelligent“ bezeichnet werden können. Dieser Wandel ist nicht nur technologischer Natur – er verändert auch unser Verständnis davon, was Computer tun können und wie sie mit der Welt interagieren.
Klassische Algorithmen: Regelbasierte Programmierung
Die klassische Computertechnik beruhte im Wesentlichen auf der Formalisierung menschlicher Logik. Programmierer formulierten explizite Anweisungen, mit denen eine Maschine – schrittweise und strikt regelbasiert – eine Aufgabe ausführte. Das zugrundeliegende Modell war das des Algorithmus im engeren Sinne: eine endliche Abfolge von Instruktionen, die für bestimmte Eingaben eindeutig definierte Ausgaben erzeugt. Diese Architektur war ideal für klar umrissene Probleme: mathematische Berechnungen, Datenbankabfragen, grafische Darstellungen, automatisierte Prozesse in Industrie und Verwaltung.
Doch die Grenzen dieses Ansatzes wurden dort offensichtlich, wo Probleme nicht mehr vollständig spezifizierbar oder deterministisch lösbar waren – etwa bei der Spracherkennung, der Bildanalyse oder der Interpretation kontextabhängiger Informationen. Denn in diesen Fällen war es entweder unmöglich oder extrem aufwändig, alle notwendigen Regeln explizit zu programmieren.
Maschinelles Lernen: Lernen statt Programmieren
Mit dem Aufkommen des maschinellen Lernens änderte sich das Grundprinzip softwaretechnischer Systeme. Anstelle von festen Regeln traten statistische Modelle, die durch Erfahrung – also durch das Training an umfangreichen Daten – lernen, Aufgaben zu lösen. Besonders prägend war dabei der Aufstieg künstlicher neuronaler Netze, die als abstrahierte mathematische Modelle biologischer Nervenzellen Informationen schichtenweise verarbeiten und dadurch komplexe Muster erkennen können.
Entscheidend ist: Solche Systeme benötigen keine explizite Regeldefinition mehr durch den Menschen. Stattdessen generieren sie ihre internen Strukturen – beispielsweise Gewichtungen in einem neuronalen Netz – durch eine Optimierung auf Grundlage großer Datenmengen. Die Software „lernt“, wie ein gewünschtes Ergebnis entsteht, ohne dass der Weg dorthin im Detail vorgegeben sein muss.
Der Durchbruch durch die Transformer-Architektur
Ein wesentlicher Meilenstein dieses technologischen Umbruchs war die Entwicklung der sogenannten Transformer-Architektur im Jahr 2017. Diese Architektur revolutionierte insbesondere die Verarbeitung natürlicher Sprache, indem sie es ermöglichte, semantische und syntaktische Strukturen über lange Textpassagen hinweg zu erfassen. Modelle wie GPT (Generative Pre-trained Transformer), BERT (Bidirectional Encoder Representations from Transformers) oder T5 (Text-To-Text Transfer Transformer) demonstrieren eindrucksvoll, wie KI heute Sprachverständnis, Textgenerierung und Übersetzungen auf einem zuvor unvorstellbaren Niveau leisten kann.
Transformer-Modelle operieren nicht mehr nur lokal (z. B. von Wort zu Wort), sondern global über gesamte Kontexte hinweg – mithilfe sogenannter „Attention“-Mechanismen. Dadurch können sie bedeutungstragende Zusammenhänge erkennen und in kohärente Ausgaben überführen, die nicht nur syntaktisch korrekt, sondern semantisch überzeugend erscheinen.
Intelligenz als emergente Eigenschaft
Diese Systeme führen uns in eine neue Ära der Informationsverarbeitung, in der maschinelle Systeme Verhaltensweisen zeigen, die ehemals ausschließlich Menschen vorbehalten schienen: kontextabhängige Problemlösung, kreative Textproduktion, adaptive Interaktion. Obgleich diese Systeme kein Bewusstsein besitzen, ist die Funktionsweise ihrer „Intelligenz“ nicht länger trivial rückführbar auf menschlich geschriebene Regeln. Vielmehr entstehen Kompetenzen als emergente Eigenschaften komplexer statistischer Strukturen.
Darin liegt der eigentliche Umbruch: In der Abkehr vom programmierten Wissen hin zum „erlernten Können“. Die Maschine wird nicht mehr nur als ausführendes Werkzeug begriffen, sondern als ein System, das innerhalb definierter Parameter selbstständig Fähigkeiten erwirbt. Dieser Wandel verlangt nach neuen Formen der Kontrolle, des Vertrauens, der Erklärbarkeit – und stellt das Verhältnis von Mensch und Maschine auf eine neue Grundlage.
3. Was steckt dahinter? Die Rolle neuronaler Netze und Transformer
Die heutigen Fortschritte basieren auf sogenannten künstlichen neuronalen Netzen, die in ihrer Struktur an das menschliche Gehirn erinnern. Besonders revolutionär war der Durchbruch der sogenannten Transformer-Architektur (z. B. GPT, BERT, PaLM), die es Sprachmodellen erlaubt, Sprache in ihrer Tiefe zu erfassen – inkl. Kontext, Bedeutung, Ambiguität.
Transformer-Modelle bestehen aus Milliarden von Parametern und werden mit gewaltigen Textmengen trainiert. Statt einzelne Wörter zu analysieren, erfassen sie Zusammenhänge auf Satz- und Dokumentebene – und können daraus semantisch sinnvolle Antworten ableiten.
4. Die neue Ära der Eingabe und Ausgabe
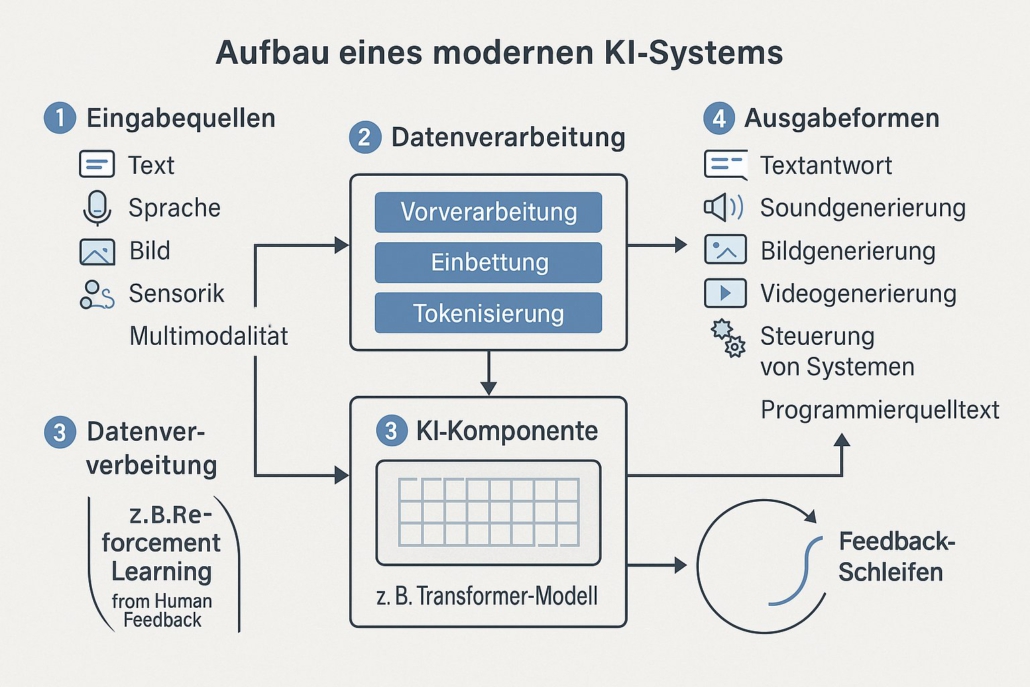
Während frühere Programme mit Maus und Tastatur gefüttert wurden, erlaubt moderne KI eine natürlichere Form der Interaktion:
Eingabe:
- Text (Chatbots, Prompt-Engineering)
- Sprache (Spracherkennung, Transkription)
- Bilder (Bilderkennung, -analyse, visuelle Suche)
- Sensoren/Datenströme (IoT, Robotik)
- Multimodalität: Kombination aus Text, Bild, Ton – gleichzeitig!
Ausgabe:
- Natürlichsprachliche Antworten
- Bilder, Videos, Musik (generativ)
- Code (automatisch generiert und korrigiert)
- Simulationen (physikalische, medizinische, wirtschaftliche Modelle)
Diese neuen Schnittstellen zwischen Mensch und Maschine sind nicht nur praktischer – sie ermöglichen eine ganz neue Art des Denkens mit Maschinen. Maschinen werden zu kreativen Partnern, zu sprachfähigen Werkzeugen.
5. Sprachmodelle im Fokus: GPT, BERT, Claude & Co.
Sprachmodelle sind derzeit das sichtbarste Gesicht der KI-Revolution. Sie verstehen, erzeugen und transformieren Sprache auf hohem Niveau. Einige bedeutende Vertreter:
- GPT (OpenAI): Extrem leistungsfähig in Textgenerierung, Konversation, Analyse
- BERT (Google): Optimiert für Verständnis und Klassifikation von Texten
- Claude (Anthropic), Gemini (Google), LLaMA (Meta): jeweils mit eigenen Schwerpunkten – etwa Sicherheit, Transparenz oder Energieeffizienz
Diese Modelle verstehen Sprache jedoch nicht im menschlichen Sinn. Sie erkennen statistische Wahrscheinlichkeiten – aber in einem solchen Maß, dass das Ergebnis menschenähnlich wirkt. Dennoch bleibt es entscheidend, zwischen Scheinkognition und echtem Verständnis zu unterscheiden.
Das Thema „Sprachmodelle im Fokus“ genauer betrachtet
Kaum ein Teilbereich der Künstlichen Intelligenz (KI) hat in den letzten Jahren eine derart dynamische Entwicklung erlebt wie die Verarbeitung natürlicher Sprache (Natural Language Processing, NLP). Im Zentrum stehen sogenannte große Sprachmodelle (Large Language Models, LLMs), die durch ihr erstaunliches Sprachverständnis und ihre Textgenerierungskompetenz neue Maßstäbe setzen. Namen wie GPT, BERT, Claude, LLaMA oder Gemini stehen exemplarisch für eine Technologie, die nicht nur die Interaktion mit Maschinen grundlegend verändert, sondern auch tiefgreifende Fragen zu Sprache, Wissen, Verantwortung und Gesellschaft aufwirft.
Von regelbasiertem NLP zu kontextsensitiven Modellen
Frühere Generationen von NLP-Systemen arbeiteten mit regelbasierten Methoden oder einfachen statistischen Verfahren wie Hidden Markov Models oder Bag-of-Words-Vektoren. Solche Modelle konnten grundlegende Strukturen erkennen, etwa Wortarten oder Satztypen, versagten jedoch meist bei der Erfassung tiefer semantischer Zusammenhänge.
Der Übergang zu kontextsensitiven Modellen, wie ihn Transformer-basierte Architekturen seit 2017 ermöglichen, markiert einen qualitativen Sprung. Diese Modelle sind in der Lage, den Bedeutungsgehalt eines Wortes dynamisch aus seinem Kontext zu erschließen – ein wesentlicher Unterschied zu früheren Techniken.
GPT: Generative Pre-trained Transformer
Das GPT-Modell (entwickelt von OpenAI) gilt als ein Meilenstein der jüngeren KI-Geschichte. Es basiert auf der Transformer-Architektur und folgt einem zweistufigen Lernverfahren: zunächst einem unüberwachten Pretraining auf riesigen Textkorpora, gefolgt von einem supervised Fine-Tuning oder Reinforcement Learning from Human Feedback (RLHF). GPT-Modelle generieren kohärente, kontextbezogene Texte, beantworten Fragen, verfassen Code oder analysieren komplexe Inhalte – und das in einer Weise, die oft kaum von menschlichem Ausdruck unterscheidbar ist.
Wichtig ist: GPT ist ein rein generatives Modell. Es sagt – statistisch optimiert – vorher, welches Wort am wahrscheinlichsten als nächstes folgt. Daraus entsteht in der Summe ein Sprachverhalten, das erstaunlich intelligent wirkt, ohne dass es sich um ein wissensbasiertes oder „verstehendes“ System im klassischen Sinne handelt.
BERT: Bidirektionales Sprachverständnis
Im Gegensatz zu GPT ist BERT (entwickelt von Google) kein generatives, sondern ein rein verständnisorientiertes Modell. Es verarbeitet Text bidirektional, das heißt: Es bezieht Kontext sowohl von links als auch von rechts mit ein. Diese Fähigkeit ermöglicht es, feine Nuancen im Text besser zu erfassen – etwa für Aufgaben wie Fragebeantwortung, Named Entity Recognition oder Sentimentanalyse.
BERT war das erste Modell, das in Benchmarks wie GLUE und SQuAD signifikante Fortschritte erzielte. Seine Architektur wurde zur Grundlage für eine Vielzahl spezialisierter Modelle wie RoBERTa, DistilBERT oder ALBERT.
Claude, Gemini & Co.: Neue Akteure im KI-Ökosystem
Mit Claude (Anthropic), Gemini (Google DeepMind), LLaMA (Meta) und anderen treten neue Modelle auf den Plan, die den Stand der Technik weiter verschieben. Claude etwa legt besonderen Wert auf Sicherheit und „konstitutionelles“ Lernen: Es folgt einem Regelkorpus, das ethisches und kontrolliertes Verhalten fördern soll. Gemini kombiniert Sprachverarbeitung mit multimodalen Fähigkeiten (Bild, Text, Code), um ein noch umfassenderes kognitives Modell zu bieten.
Diese Vielfalt zeigt: LLMs sind längst nicht mehr nur Werkzeuge der Textverarbeitung – sie entwickeln sich zu Schnittstellen zwischen Mensch, Wissen und Technologie.
Herausforderungen: Halluzination, Bias, Transparenz
Trotz ihrer beeindruckenden Leistungsfähigkeit stehen Sprachmodelle vor großen Herausforderungen. Eines der zentralen Probleme ist die sogenannte Halluzination: Die Modelle „erfinden“ mitunter Fakten, die plausibel klingen, aber nicht korrekt sind. Auch Bias – also die Verzerrung von Aussagen durch Trainingsdaten – bleibt ein ungelöstes ethisches Problem.
Zudem ist die Erklärbarkeit („Explainability“) der Modelle begrenzt: Ihre Entscheidungen beruhen auf Milliarden von Parametern, deren Wechselwirkungen schwer nachvollziehbar sind. Damit entstehen neue Anforderungen an KI-Governance, Transparenz und Kontrolle.
Fazit: Sprache als Schnittstelle zur Intelligenz
Sprachmodelle sind mehr als bloße Werkzeuge – sie sind die ersten Systeme, die sich dem menschlichen Kommunikationsverhalten auf breiter Ebene annähern. Mit jedem Entwicklungsschritt wird deutlicher: Sprache ist nicht nur ein Medium der Information, sondern auch ein Medium der Macht, des Denkens und der Weltgestaltung. Genau darin liegt ihre transformative Kraft – und die Herausforderung, die sie für eine verantwortliche, zukunftsorientierte KI-Nutzung bedeutet.
6. Gesellschaftliche Relevanz: Warum das alles so wichtig ist
Die Fortschritte in der KI sind nicht nur ein technisches Thema. Sie verändern unsere Arbeitswelt, unser Bildungssystem, unsere Kreativität, unsere Politik. Fragen nach Verantwortung, Ethik, Regulierung und Bildung drängen sich auf.
KI ist dabei kein Akteur, sondern ein Werkzeug – allerdings eines, das mächtig genug ist, um gesellschaftliche Ordnungen zu verschieben. Deshalb braucht es nicht nur Entwickler, sondern auch Denker, Kritiker, Ethiker und Visionäre, um diesen Wandel zu begleiten.